真实案例:Cloudflare 近期两次宕机
第一次服务中断:2025年11月18日
2025 年 11 月 18 日 11:20 UTC,Cloudflare 网络开始出现严重故障。这是Cloudflare 自 2019 年以来最严重的一次服务中断,在过去 6 年多时间里从未发生过导致大部分核心流量中断的故障。
下图显示了 Cloudflare 网络处理的 5xx 错误 HTTP 状态代码的数量:
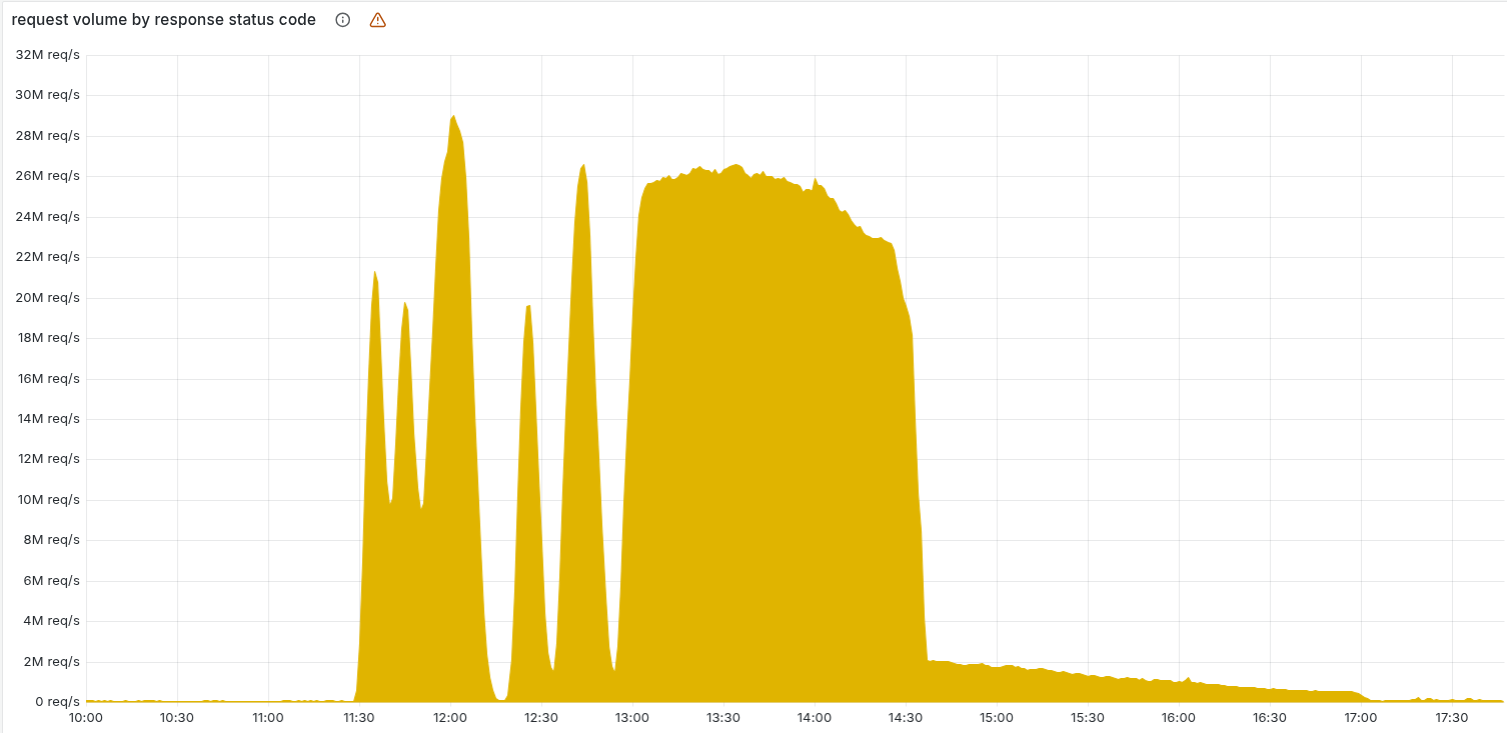
时间线
| 时间 (UTC) | 状态 | 描述 |
|---|---|---|
| 11:20 | 故障开始 | 错误的特征文件开始在网络中传播 |
| ~13:05 | 开始排查 | 回滚部分变更,但问题仍在持续 |
| 14:30 | 核心恢复 | 停止生成错误文件,手动插入已知好文件 |
| 17:06 | 完全恢复 | 所有系统恢复正常 |
根因分析
Cloudflare 的 Bot Management 系统使用机器学习模型为每个请求生成机器人评分。该模型依赖一个"特征配置文件"(feature file),包含用于判断流量是否为自动化的特征集合。该文件每几分钟刷新一次并发布到整个网络。
故障由 ClickHouse 数据库权限变更触发:
- 权限变更导致查询输出大量重复的"特征"行
- 特征文件大小增加了一倍,超过了软件设置的大小限制
- 核心代理软件(FL 和 FL2)读取该文件时,超出限制导致崩溃
- 对于旧版 FL 代理,虽然未返回 5xx 错误,但机器人评分全部变为 0,导致误封大量正常流量
暴露问题
- 异常处理不合理。 软件设置了特征文件大小限制以保护系统,但当文件超出限制时直接崩溃,而非采用降级策略(如跳过 Bot Management 模块继续处理流量)。代码里设置最大值保护系统无可厚非,但要区分核心流程和非核心流程,避免一个非核心逻辑的错误影响整个系统。
- 止损服务循环依赖。 Cloudflare 的状态页面托管在基础设施之外,本应独立。但由于登录页面使用 Turnstile 验证,而 Turnstile 依赖 Cloudflare 网络,导致大部分用户无法登录状态页面。止损系统不应依赖于它所管理的服务。
- 配置发布没有灰度。 Cloudflare 的配置发布使用全局配置系统 Quicksilver,几秒钟内传播到所有服务器,没有像代码变更一样使用渐进式部署系统。这意味着任何配置错误都会瞬间影响全球网络。
Cloudflare 的改进措施
- 审核、改进并测试所有处理网络流量的系统的故障模式,确保在意外错误状态下也表现出明确定义的行为。
- 更改内部"紧急访问"程序并消除任何循环依赖关系,确保事件期间能快速访问所有系统。
- 实施"Fail-Open"错误处理策略:当配置文件损坏或超出范围时,记录错误并默认到已知良好状态或跳过评分继续处理流量,而非硬性失败。
- 配置变更也采用与软件发布相同的渐进式部署系统。
第二次服务中断:2025年12月05日
2025 年 12 月 5 日 08:47 UTC,Cloudflare 部分网络开始出现严重故障。总影响时间约 25 分钟,受影响客户约占 Cloudflare 处理的 HTTP 总流量的 28%。
下图显示了事件发生期间 Cloudflare 网络返回的 HTTP 500 错误(底部的红线),以及与未受影响的 Cloudflare 总流量(顶部的绿线)之间的对比:
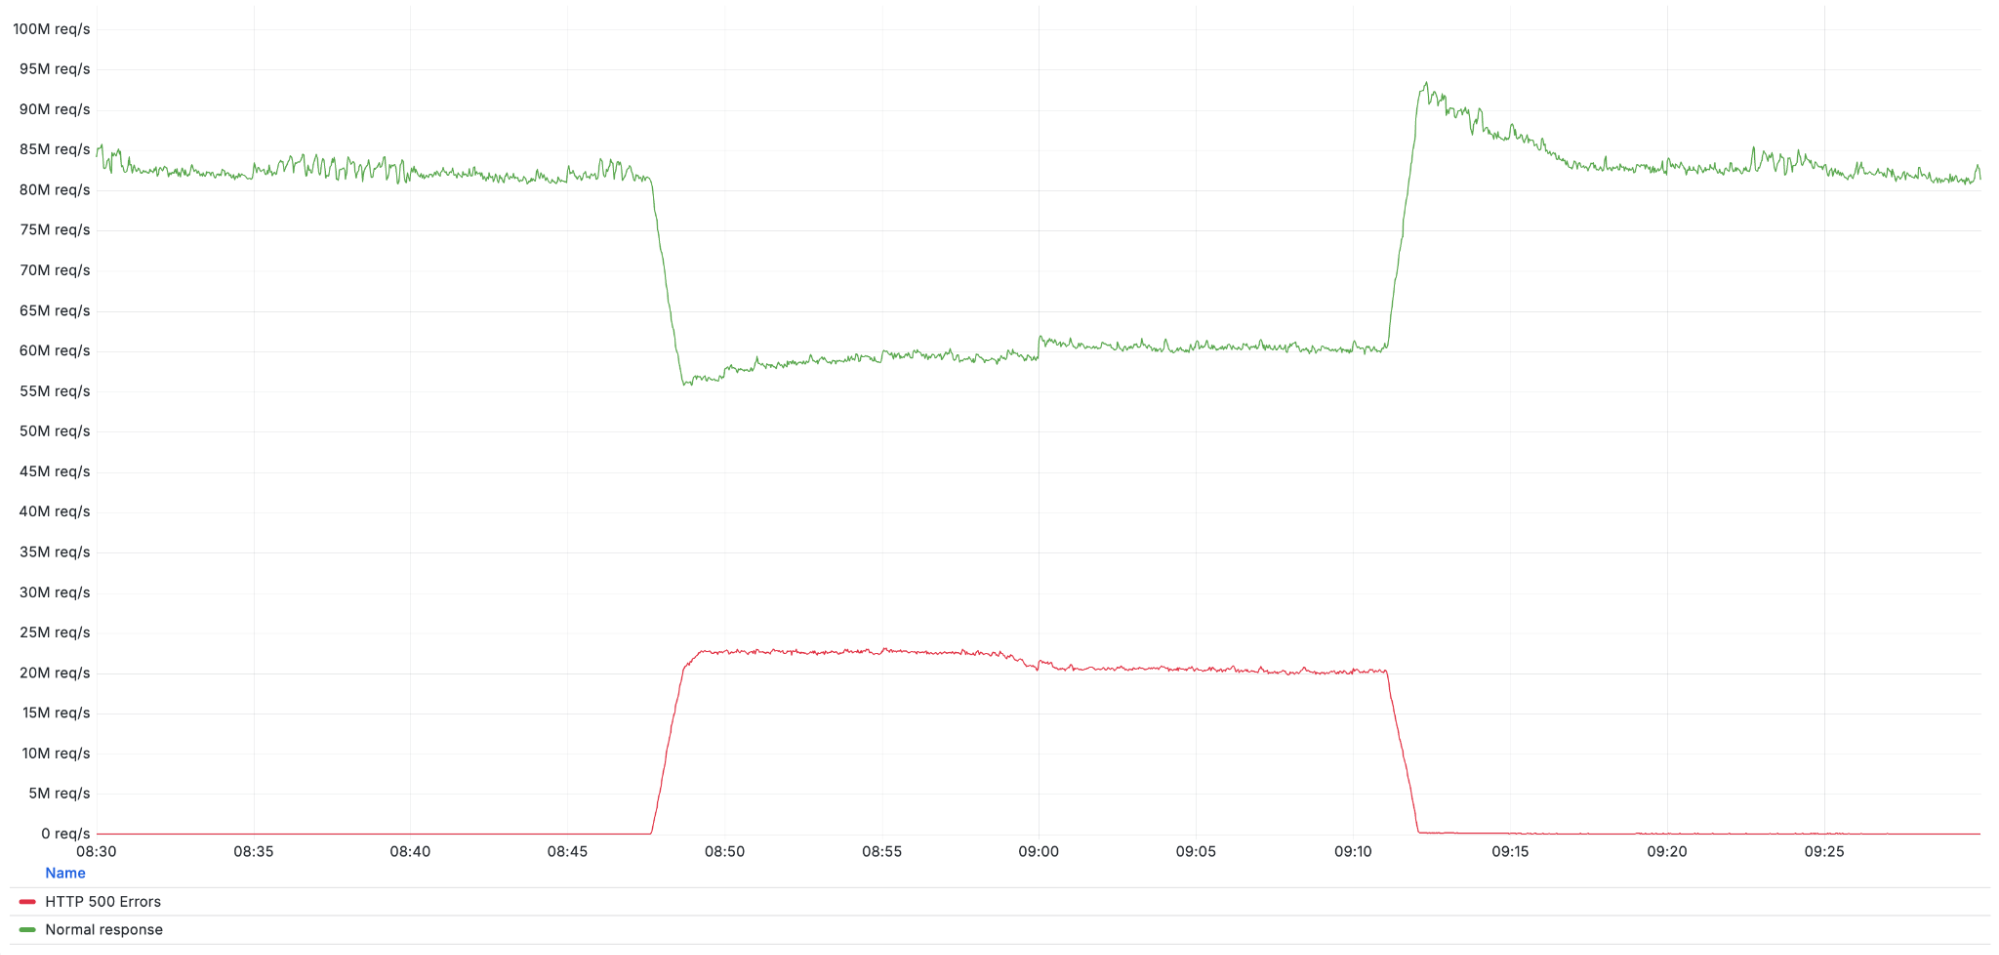
时间线
| 时间 (UTC) | 状态 | 描述 |
|---|---|---|
| 08:47 | 故障开始 | 配置变更部署并传播到网络 |
| 08:48 | 全面影响 | 变更完全传播 |
| 08:50 | 事件声明 | 自动化告警触发 |
| 09:11 | 开始回滚 | 配置变更被撤销 |
| 09:12 | 事件结束 | 回滚完全传播,流量恢复 |
根因分析
为了保护使用 React 的客户免受关键漏洞 CVE-2025-55182 的影响,Cloudflare 执行了一项安全缓解措施:将 WAF 缓冲区大小从 128KB 增加到 1MB(Next.js 的默认限制)。
第一项更改:使用渐进式部署系统逐步增加缓冲区大小。
第二项更改:在试运行过程中发现内部 WAF 测试工具不支持增加的缓冲区大小。由于该工具不影响客户流量,团队决定将其关闭。
问题出在第二项更改的实施方式:
- 使用 Quicksilver 全局配置系统实施关闭操作
- 该系统不支持渐进式部署,而是几秒钟内将更改传播到所有服务器
- 该系统在 11 月 18 日事故后已在审核中
在 FL1 代理版本中,关闭 WAF 规则测试工具触发了 Lua 代码中的一个隐藏 bug:
-- FL1 代理中的错误代码
if rule_result.action == "execute" then
    -- 当规则被跳过后,rule_result.execute 不存在,导致 nil 值访问
    rule_result.execute.results = ruleset_results[tonumber(rule_result.execute.results_index)]
end
该 bug 已存在多年,在 FL2(用 Rust 重写)中不存在。当 killswitch 系统跳过"execute" 动作后,代码仍尝试访问不存在的 rule_result.execute 对象,导致 Lua 异常:
[lua] Failed to run module rulesets callback late_routing: /usr/local/nginx-fl/lua/modules/init.lua:314: attempt to index field 'execute' (a nil value)暴露问题
- 配置变更未灰度。 Quicksilver 系统没有渐进式部署机制,配置错误会瞬间影响全球网络。没有灰度就没有局部观察的机会,影响面最大化。
- 重大事故后没有冷静期。 上次重大事故(11月18日)发生仅 17 天后,又出现重大事故,严重损害客户信心。Cloudflare 承诺在完成改进措施前锁定所有网络变更。
Cloudflare 的改进措施
- 配置变更也使用渐进式部署:对传播到网络的任何配置更改进行受控部署,就像软件二进制版本发布一样。
- 增强版本控制与回滚能力:配置变更应包含健康验证和快速回滚能力。
- 锁定网络变更:在重新开始变更之前,确保增强渐进式发布和回滚系统。
线上故障处理经验分享
事前:构建有韧性的系统
系统故障是必然的——不是"会不会"的问题,而是"什么时候"的问题。与其祈祷故障永不发生,不如把系统设计成能从故障中恢复。
区分核心与非核心流程
很多故障的根源是:非核心逻辑的错误搞垮了核心链路。
┌─────────────────────────────────────────────────┐
│  请求入口                                        │
└───────────────────┬─────────────────────────────┘
                    │
        ┌───────────┴───────────┐
        ▼                       ▼
┌───────────────┐     ┌───────────────────┐
│   核心流程     │     │   非核心流程       │
│  认证 → 业务   │     │  Bot评分/风控      │
│  处理流量      │     │  特征提取          │
└───────────────┘     └───────────────────┘
        │                       │
        │   非核心异常          │
        │──────────────────────┘
        │      ❌ 崩溃         │
        ▼                       ▼
┌─────────────────────────────────────┐
│         整个请求失败                  │
└─────────────────────────────────────┘
Cloudflare 第一次事故就是典型案例:Bot Management 的特征文件超限,导致核心代理崩溃。非核心流程的错误不应该影响核心链路。
| 场景 | 做法 |
|---|---|
| 强依赖不可用 | 应用启动时检查,异常直接退出,提前暴露问题 |
| 弱依赖不可用 | 降级处理,如权限系统异常时使用最近审批人 |
| 任何异常 | 判断是否需要告警,让运维感知到问题 |
消除循环依赖
止损系统最怕什么?怕它要救的系统恰恰是它自己的依赖。
Cloudflare 的控制台托管在基础设施外,本应独立,却因登录需要 Turnstile 验证——而 Turnstile 依赖 Cloudflare 网络——导致故障时用户无法使用控制台。
┌──────────────┐         ┌──────────────┐
│  状态页面     │ ──依赖──▶│  Turnstile   │
└──────────────┘         └──────────────┘
      │                        │
      │        ┌───────────────┘
      │        │
      ▼        ▼
┌─────────────────────────────────────┐
│       Cloudflare 核心网络            │
│    (故障时全部不可用)               │
└─────────────────────────────────────┘
原则:止损系统应该是"物理隔离"的。 部署系统、K8S 管控组件、监控告警平台——这些基础管控系统要用独立部署,避免和业务系统形成循环依赖。
变更管理的三原则
Cloudflare 第二次事故的根因之一是 Quicksilver 配置系统不支持灰度,配置变更瞬间传遍全球。
| 要求 | 说明 |
|---|---|
| 可灰度 | 任何变更(代码+配置)都要能逐步放量,先灰度 1% 观察 |
| 可观测 | 变更伴随监控指标,异常第一时间能看到 |
| 可回滚 | 准备好回滚预案 |
实践建议: 重大功能上线时,用功能开关(Feature Flag)控制。重大功能往往需要多次迭代完善,异常时只需关闭开关即可恢复,无需回滚代码,也就不会影响其他需求的上线进度。
预案与演练
预案不是写完就完事,而是需要定期验证的。
预案覆盖的场景:
- 单节点故障(一主多从架构下主节点挂了、某台机器挂了)
- 机房级别故障(整个机房掉电、机房网络分区)
- 依赖服务故障(下游超时/熔断/降级)
验证方式:
- 定期演练:注入故障(如断网、杀掉进程),看系统表现是否符合预期
- SOP 腐化检查:每次故障演练后更新 SOP,保证 SOP 的正确性
工具脚本沉淀
故障发生时,时间是最宝贵的。没人有精力在现场学习新命令(🐶老板看着呢)。
故障发生时的理想状态           实际状态
─────────────────────────    ─────────────────────────
grep /var/log/xxx             grep /var/??? 日志路径对吗?
ps -ef | grep java            ps -e?? f 参数记混了
kubectl rollout undo          rollback 还是 undo?
为什么需要沉淀:
- 经过验证 vs 临时搜索:网上搜的命令可能不适用于你的环境,团队内部沉淀的命令是验证过的
- 减少认知负荷:故障压力下人容易慌,熟悉的命令能减少犯错概率
沉淀什么:
| 类别 | 示例 |
|---|---|
| 日志查看 | tail -f、grep 过滤模式、journalctl 技巧 |
| 进程诊断 | CPU/内存占用排序、线程堆栈导出 |
| 网络诊断 | curl 健康检查、telnet 端口、tcpdump 抓包 |
| 容器/K8S | 日志查看、Pod 状态、重启策略调整 |
| 数据库 | 连接检查、慢查询、死锁排查 |
主动学习
故障复盘是成本最高的学习方式。更高效的方式是学习别人的事故。
Cloudflare 的事故报告是行业标杆——他们不仅公开了时间线、根因、改进措施,还把内部系统的设计缺陷也一并披露。Google SRE Book 里的"Postmortem Culture"章节同样值得细读。
被动成长 ──▶ 事故中学习 ──▶ 代价高、成长慢
主动学习 ──▶ 事故前阅读 ──▶ 成本低、提前规避
事中:快速止损是第一优先
核心目标是止损,而不是先排查清楚,定位到根因,再去止损。
确认故障和影响范围
感知到故障后,先确认系统状态,排查误报的情况。如果不清楚故障对应的影响,就对核心功能进行冒烟测试,得出影响范围(前提是不要花费太多时间)。随后对故障进行通报,描述清楚现状,影响范围和当前动作。对于一些不确认的推测,也可以补充下,但要明确说明正在确认。
优先梳理近期变更
大部分故障都是变更引起的,只有我们找到这个变量,就能快速止损。
在梳理近期变更时,可以记录下时间线,方便理清问题的同时,后续复盘也能用到。
先止损,再定位
查找是否有相关SOP,如有,请严格按照SOP执行。避免当时不清醒,紧张,考虑不全面。
其他常见的止损手段有:
- 切流到正常的机房
- 回滚近期变更
- 摘流异常节点
- 关闭功能开关
- 限流、熔断、降级
如果是晚上变更出现异常,应立即回滚,并排查清楚根因,并停止变更,等到第二天白天再继续变更。避免晚上不清醒,对异常处理不当,评估不准确,继续变更造成事故。
止损也需要灰度,止损动作本质上也属于线上变更,应该遵循可灰度原则,避免引入新的故障。一定要禁止梭哈。
该升级就升级
如果故障影响较大,或者短时间内无法解决,就应该告知团队和老板你的难处,把问题抛出来,寻求更多支持。别因为压力的原因,只想着自己如何尽快解决这个问题。
故障通报也要定时同步,让大家知晓止损进展,哪怕没有进展,也要说明。
保持良好的心态
紧急情况下,紧张、焦虑的情绪会随之产生。我们要知道情绪的存在,不要被它带着走。
当前最重要的事情是解决这个问题,尽力做好就行,不要管其他的。例如这个事故如何定责,要背责任怎么办。
我见过在同一个事故中,截然不同的处理方式。有个变更导致了故障,随后在回滚时操作失误,引发了其他问题。其中一个同学比较紧张焦虑,在会上不时的说出一些情绪化的语言,记不清原话了,大概就是在埋怨、担忧。而另一个同学就稳重很多,会上发言都是围绕着当前问题的处理,没有一句废话。
恢复后继续观察
故障恢复后,需要对系统核心功能进行冒烟测试,确保一切正常。
检查监控大盘、服务日志,确保服务运行正常。
事后:复盘与改进
故障恢复后,不代表事情结束,更有价值的是故障后的复盘。发现系统或者流程上存在的问题,避免同类问题再次发生。
尽快复盘
复盘材料编写应尽量在故障恢复后的 24 小时内进行。时间拖得越久,参与者对现场的记忆越模糊,很多关键细节也会丢失。
即使事中已经尽力保存日志、监控和操作记录,也很难百分之百还原现场,因此复盘越早越好。
找到根因,也要找到放大因素
复盘不能停留在“某段代码有 Bug”或“某个人配置错了”。
人一定会犯错,更重要的问题是:为什么一次普通错误能够进入生产,又为什么会扩大成严重故障?
除了直接根因,还要继续分析:
- 为什么在变更方案评审时没发现问题
- 为什么变更时 doubleCheck 没有发现问题
- 为什么测试和灰度没有发现问题
- 为什么监控没有更早告警
- 为什么异常没有被隔离或降级
- 为什么回滚和止损花了这么长时间
- 为什么现有 SOP 没有发挥作用
Cloudflare 的两次事故中,代码和配置问题只是直接原因。缺少灰度、异常处理不合理,以及止损系统存在循环依赖,才是故障影响被放大的关键因素。
形成明确的改进项
每条改进措施都应有负责人和完成时间,避免复盘结束后只留下一份文档。
改进项通常包括:
- 修复直接导致故障的缺陷
- 补充监控和告警
- 增加灰度、回滚和降级能力
- 更新故障处理 SOP
- 增加自动化测试或故障演练
- 消除单点和循环依赖
改进项需要持续跟踪直到关闭,应该录入到相关平台进行追踪。
重大故障后设置冷静期
重大事故发生后,可以设置一段变更冷静期。例如未来一周内暂停非紧急线上变更,只允许故障修复和必要操作。
如果连续发生事故,会放大事故影响,进一步损害用户信任。
让系统从故障中成长
故障本身不会自动带来成长,只有完成复盘、落实改进并验证效果,故障成本才没有白白付出。
一次好的复盘,最终应该让监控更灵敏、止损更迅速、系统更健壮,也让团队下一次面对类似问题时更加从容。
总结
线上故障处理是一门系统工程,需要在事前预防、事中止损、事后复盘三个阶段都做到位:
- 事前:构建有韧性的系统,做好预案和演练
- 事中:止损优先,快速恢复,及时协同
- 事后:及时复盘,持续改进,让系统更健壮
每一次故障都是系统和团队成长的机会。
参考资料
- Cloudflare outage on November 18, 2025
- Cloudflare outage on December 5, 2025
- Code Orange: Fail Small — our resilience plan following recent incidents
- Google SRE Book - Postmortem Culture
- Netflix Chaos Engineering Principles